Modèle de rapport d’incident pour un site événementiel
Un tableau d’état peut dire « résolu » alors que le lien de billetterie échoue encore. Le rapport précise les tâches du public touchées, les faits connus et la vérification du retour au service. Ce modèle complète le plan de responsabilités pendant l’incident.
La rédaction de Boletolibre
Publié
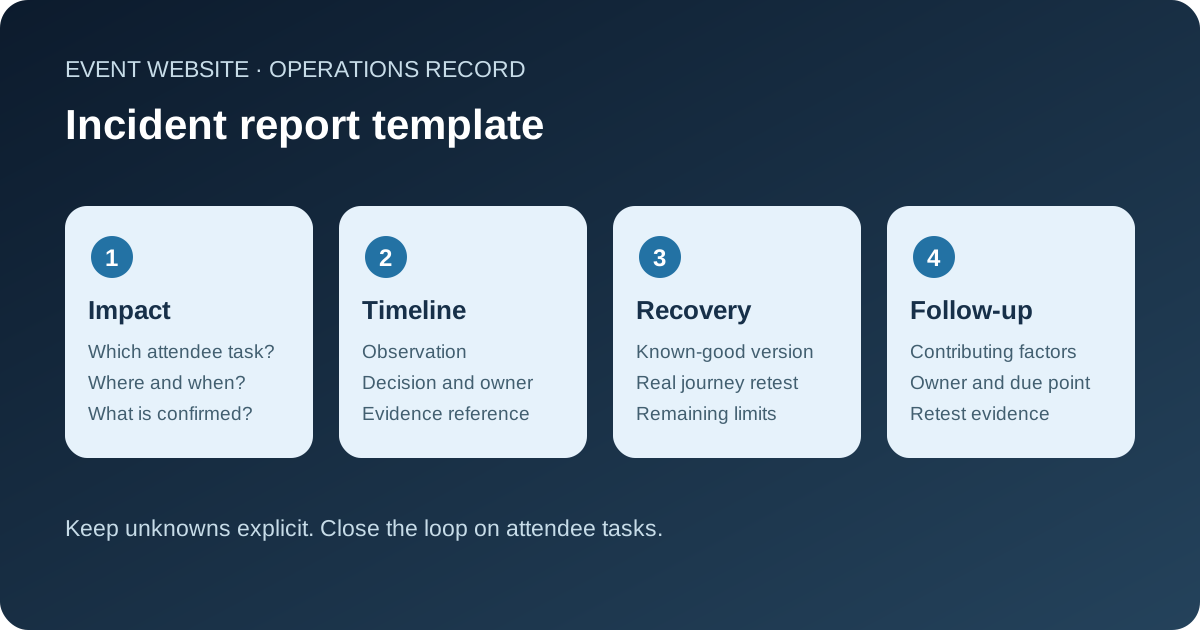
Télécharger le rapport modifiable
Télécharger le modèle d’incident (Markdown en anglais)
Préparez une copie vierge avant la vente ou l’événement. Notez URL, régions, langues, limites temporelles, actions, dossiers fournisseur, vérifications et responsables. Conservez journaux et captures dans un espace autorisé ; n’ajoutez pas de données d’acheteurs ou de secrets au rapport.
Décrire d’abord l’impact public
Identifiez l’édition et la phase : prévente, vente, ouverture ou après l’événement. Indiquez tâche touchée, lieu d’observation et source. Une page d’accueil accessible ne prouve pas inscription, paiement externe, confirmation ou consignes d’accès. Si l’événement est sur Boletolibre.com, contrôlez sa fiche publique et le véritable lien de billetterie si pertinent.
Distinguez première panne confirmée et première détection. Limitez région, langue ou appareil seulement avec preuves. Une baisse de visites ne chiffre pas les achats perdus. AWS recommande de prioriser selon l’impact et de désigner les responsables.[1]
Conserver une chronologie factuelle
Inscrivez alerte, signalement, changement, escalade, atténuation, message et nouveau contrôle avec fuseau horaire. Chaque entrée précise source, preuve, décision et responsable. Préservez ce que l’équipe savait alors, même si des faits ultérieurs le corrigent.
- Reliez publication, changement DNS ou dossier fournisseur à son historique : la proximité ne prouve pas la cause.
- Gardez journaux et captures avec accès limité et propriétaire de conservation.
- Notez le message validé et son heure sans remplacer le plan de communication.
Google SRE met l’accent sur chronologie, données d’impact et actions concrètes, sans recherche de coupable.[3]
Vérifier le parcours rétabli
Séparez contournement et correction finale. Notez approbation, version connue comme fonctionnelle et voies encore dégradées. Une personne ouvre les informations, inscription, achat officiel, confirmation et aide depuis un client public ; elle consigne résultat, heure, langue et preuve.
Si l’achat se fait chez un autre fournisseur, contrôlez votre lien et la transition ; il confirme lui-même le traitement. Gardez les données d’essai hors des ventes réelles.
Analyser après stabilisation
Séparez causes confirmées, facteurs possibles et inconnues. Pourquoi la panne était-elle possible, pourquoi les contrôles l’ont-ils manquée et qu’est-ce qui a ralenti la réponse ? AWS demande impact, preuves et prévention, sans s’arrêter à « erreur humaine ».[2]
Un lien de billet modifié ou une langue présentant une ancienne entrée peuvent produire des effets différents. Une possible exposition de données exige une équipe qualifiée ; ce modèle ne constate pas une violation.
Fermer les actions après contrôle
Attribuez propriétaire, échéance, preuve de réalisation et résultat du nouvel essai à chaque action. Une attribution ne vaut pas achèvement. Revoyez les tâches ouvertes avant la prochaine vente ou édition.
Diffusez les enseignements utiles tout en protégeant les journaux. Le modèle ne remplace ni procédure d’urgence, ni enquête de sécurité, ni appréciation contractuelle.
Sources et lectures complémentaires
- Responding to eventsAWS Well-Architected Framework · Consulté
- Perform post-incident analysisAWS Well-Architected Framework · Consulté
- Postmortem Culture: Learning from FailureGoogle SRE Workbook · Consulté