Garder les brouillons événementiels hors des résultats de recherche
Programme, annonce d’intervenant ou page d’inscription peuvent attendre une validation. Déterminez d’abord si le brouillon est confidentiel ou simplement prématuré pour la recherche. Une directive règle la découverte; le contrôle d’accès règle qui peut lire.
La rédaction de Boletolibre
Publié
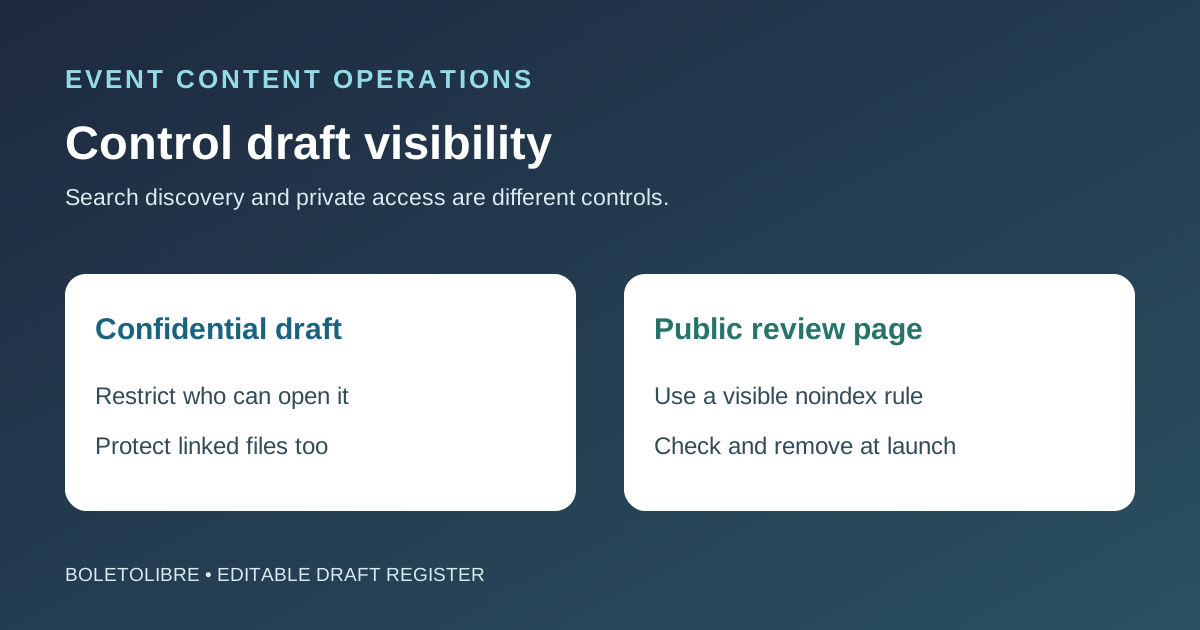
Classer le brouillon
Télécharger le registre modifiable (Markdown, en anglais)
Inventoriez URL, PDF, images et liens de billets créés pour la revue. Notez responsable, relecteur, risque de partage et accès direct éventuel. Retirez les brouillons de la navigation, des flux et du sitemap avant approbation, mais une URL sans lien n’est pas un secret.
Restreindre les contenus confidentiels
Si lieu, programmation, prix ou billet doivent rester privés, utilisez un aperçu authentifié ou ne publiez pas le fichier. Google conseille de protéger les contenus confidentiels par mot de passe. Une page noindex reste visitable par URL; robots.txt peut révéler son chemin et ne bloque pas les personnes. Vérifiez aussi PDF et images liés.[1][2]
Utiliser noindex convenablement
Pour une page non sensible que les relecteurs ouvrent sans compte, une balise meta noindex ou un en-tête X-Robots-Tag demande aux moteurs compatibles de ne pas l’indexer. Google doit pouvoir explorer l’URL pour voir la règle; robots.txt peut l’en empêcher. L’en-tête convient aussi aux PDF. Contrôlez réponse et inspection d’URL; le retrait d’un résultat existant n’est pas immédiat.[1][2]
Lever les blocages au lancement
À l’approbation, vérifiez URL finale, texte, dates, billetterie et traductions. Retirez noindex ou restriction d’aperçu uniquement lorsque la page doit être publique; ajoutez liens et sitemap puis vérifiez qu’aucune directive ne subsiste. Gardez les ressources sensibles protégées. Notez responsable et preuve dans la fiche.[1][2]
Sources et lectures complémentaires
- Block Search Indexing with noindexGoogle Search Central · Consulté